Les faits d’un cabinet vont dans une table écrite, pas dans les poids du modèle
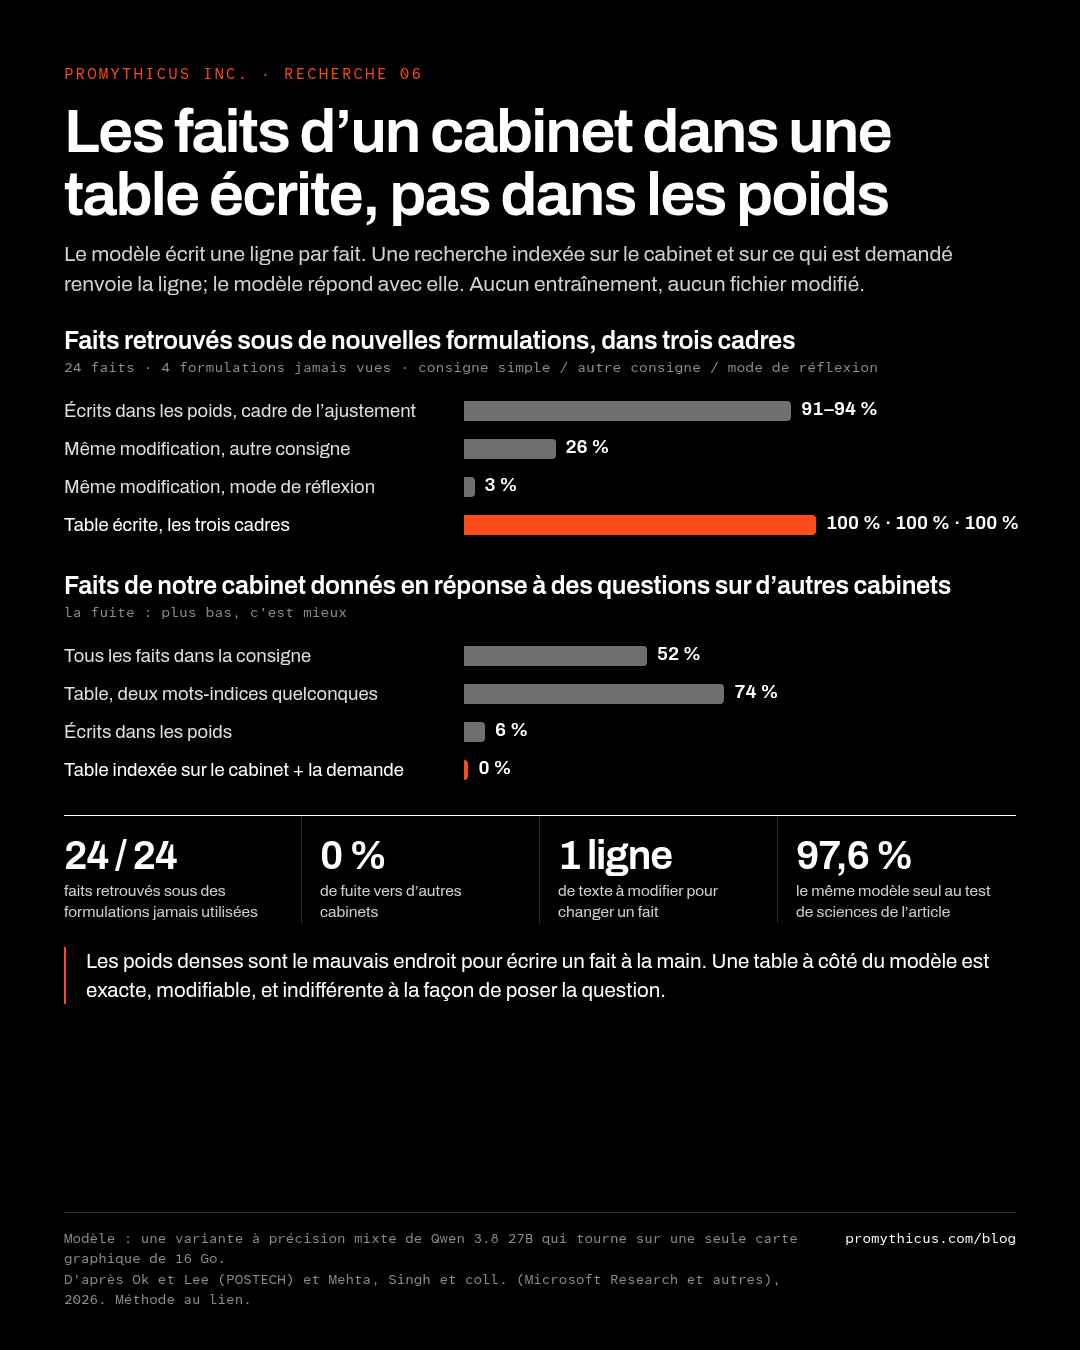
Nous avons donné à un modèle d’IA local 24 faits sur un cabinet fictif, de deux façons. Écrits dans les poids du modèle, ils étaient retrouvés de 91 à 94 % du temps, mais seulement dans le format de consigne utilisé : 26 % sous une autre consigne et 3 % avec le mode de réflexion. Écrits par le modèle sous forme de lignes dans une table, et retrouvés par le nom du cabinet plus ce qui est demandé, ils ont été retrouvés 100 % du temps dans les trois cadres, et jamais donnés en réponse à une question sur un autre cabinet. Rien n’a été entraîné et aucun fichier de modèle n’a été modifié. L’idée de la table vient de deux articles parus ce mois-ci, cités plus bas.
Le problème
L’assistant d’un cabinet doit connaître le cabinet : ses gens, ses systèmes, ses procédures. Aucun modèle n’a été entraîné là-dessus. Une façon de les ajouter est de les écrire directement dans les poids du modèle, par un seul calcul, sans entraînement. Nous l’avons essayé (l’essai complet est ici) : cela fonctionnait dans le format de consigne de l’ajustement et nulle part ailleurs. Changez la consigne en tête de conversation, et les faits disparaissaient. Cet article essaie un autre endroit où les mettre.
À qui revient l’idée
Deux articles parus en novembre 2026 ont changé notre regard sur le problème. Nous n’avons pas inventé ce qui suit; nous l’avons appliqué.
- Hyunjong Ok et Jaeho Lee (POSTECH), Weight-Space Programming Doesn’t Need Transformers. Quand on demande à un grand modèle d’en écrire un autre à la main, sans entraînement, il n’écrit pas un réseau de neurones. Il écrit des faits en texte simple et les compile dans une table lue par une procédure fixe. Chaque réponse remonte à une ligne écrite. Leur propre conception, une mémoire associative, adresse ses lignes par des paires de concepts.
- Yash Mehta, Chandan Singh et leurs collègues (Microsoft Research, Johns Hopkins, Columbia, NYU), Interpretable weight-space programming. Écrire à la main, mesurer sur des exemples qu’on a le droit de regarder, réviser avec une raison écrite, et mesurer une seule fois, à la fin, sur des exemples jamais regardés.
Les deux s’appuient sur Sparks of Weight-Space Programming, de Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab.
D’abord, leur résultat tient-il?
Ok et Lee ont publié leurs modèles écrits sous forme de fichiers texte. Nous en avons reconstruit quatre et les avons mesurés avec notre propre outil sur les mêmes 3 530 questions de sciences de niveau scolaire (ARC) :
| Leur modèle publié | Notre mesure | Publié |
|---|---|---|
| Mémoire associative, première génération | 49,59 % | 49,59 % |
| Mémoire associative, cinquième génération | 52,37 % | 52,37 % |
| Table conçue par le modèle qui écrit | 50,80 % | 50,80 % |
| Transformeur à deux couches écrit à la main | 34,22 % | 34,15 % |
Il tient exactement. La table se construit en quelques secondes et répond aux 3 530 questions en une seconde environ sur un processeur ordinaire.
L’essai sur les faits d’un cabinet
- Modèle : une variante à précision mixte de Qwen 3.8 27B qui tourne sur une seule carte graphique de 16 Go.
- Faits : 24 faits inventés sur un cabinet d’avocats fictif (des personnes, des noms de systèmes, des nombres).
- Écriture : le modèle transforme lui-même chaque fait en une ligne : les mots qu’on emploierait pour le demander, puis la réponse. Par exemple (l’essai est en anglais) : privacy officer, data protection officer, DPO > Signe Halvorsen, sous le nom du cabinet.
- Lecture : une question ne fait revenir une ligne que si elle contient à la fois le nom du cabinet et des mots de ce qui est demandé. C’est la mémoire adressée par paires d’Ok et Lee. Le modèle répond ensuite avec la ligne sous les yeux.
- Mesure : quatre formulations de chaque fait jamais utilisées pour écrire quoi que ce soit; les mêmes questions sur trois autres cabinets inventés; quarante questions de culture générale.
| Où sont les faits | Retrouvés, nouvelles formulations | Nos faits donnés pour d’autres cabinets |
|---|---|---|
| Dans les poids, format de l’ajustement | 91 à 94 % | 6 % |
| Dans les poids, autre consigne en tête | 26 % | 0 % |
| Dans les poids, mode de réflexion | 3 % | 5 % |
| Tous placés dans la consigne | 100 % | 52 % |
| Table écrite, consigne simple | 100 % | 0 % |
| Table écrite, autre consigne en tête | 100 % | 0 % |
| Table écrite, mode de réflexion | 100 % | 0 % |
Les réponses de culture générale n’ont pas changé (95 %, comme le modèle intact).
Deux erreurs en chemin, et ce qui les a corrigées
- La première table fuyait beaucoup : 74 %. Une question sur l’associé directeur d’un autre cabinet faisait revenir la ligne du nôtre, parce que les mots du poste suffisaient à la trouver. Exiger que le nom du cabinet soit la moitié de la clé de recherche a ramené la fuite à zéro. Une simple table de mots-clés ne le peut pas; la table à paires, oui.
- Un fait sur 24 manquait. En suivant la boucle du second article, nous avons regardé les formulations que nous avions le droit de regarder : il échouait là aussi. La cause était chez nous : notre lecteur jetait « IT » (l’informatique) comme le mot courant « it », si bien que le responsable de l’informatique ressemblait à tout autre responsable. Une ligne de code, sa raison écrite à côté, et les formulations jamais vues sont passées de 95,8 % à 100 %.
Ce que cela change pour un serveur privé
- Cela ne peut pas dépendre de la façon de poser la question. Le fait est dans une ligne de texte, pas dans un motif de poids lié à une consigne.
- Cela ne répond pas pour le mauvais cabinet. C’est important pour quiconque garde les faits de plusieurs clients sur une même machine.
- Changer un fait, c’est modifier une ligne. Pas de réentraînement, pas de nouveau fichier de modèle, et la ligne montre d’où vient une réponse.
Et pour la culture générale?
Les tables de ces articles contiennent des sciences de niveau scolaire; nous avons donc essayé de les combiner à notre modèle sur leur propre test. Notre modèle seul répond à 97,6 % des 3 530 questions, en 0,18 seconde chacune. La meilleure table publiée répond à 52,3 %; avec 3 331 lignes écrites par notre modèle à partir des questions d’exercice, 54,5 %. Laisser la table répondre quand elle est sûre, puis un petit modèle général, puis le nôtre, donne 90 % à environ deux fois la vitesse, ou 97 % à 1,2 fois. La table y ajoute peu : pour la culture générale, un modèle entraîné est simplement meilleur, comme le disent les deux articles. Pour les faits propres à un cabinet, qu’aucun modèle n’a appris, la table est le bon outil.
Une dernière mesure pour la vitesse : la réponse de notre modèle est déjà complète à la couche 52 sur 64. S’arrêter là garderait 97,0 % et épargnerait environ un sixième du travail. C’est mesuré, pas construit.
Limites
- 24 faits sur un seul cabinet inventé, avec des réponses courtes. Les faits d’un vrai cabinet sont plus désordonnés, et les lignes seraient écrites à partir de ses documents.
- Un seul passage de chaque essai.
- Une table retrouve ce qui a été écrit. Elle ne raisonne pas dessus; c’est le modèle qui s’en charge.
Questions et réponses
- Comment donner à une IA privée les faits propres à un cabinet?
- Dans notre essai, sous forme de lignes dans une table que le modèle écrit et relit, retrouvées par le nom du cabinet plus ce qui est demandé. Les 24 faits ont été retrouvés dans tous les cadres de consigne, et aucun n’a été donné en réponse à une question sur un autre cabinet.
- Pourquoi ne pas écrire les faits dans le modèle lui-même?
- Nous avons essayé. Les faits ne tenaient que dans le format de consigne utilisé pour les écrire : de 91 à 94 % là, 26 % sous une autre consigne, 3 % avec le mode de réflexion.
- N’est-ce pas simplement de la recherche?
- C’en est proche. Ce que la table ajoute, c’est la clé à deux éléments : une ligne ne revient que si la question nomme à la fois à qui appartient le fait et ce qui est demandé. Avec les faits simplement placés dans la consigne, le modèle donnait les faits de notre cabinet pour d’autres une fois sur deux; avec la table à clé, jamais.
- Sur quelles recherches cela repose-t-il?
- Sur celles d’Ok et Lee, à POSTECH, qui ont montré que les modèles écrits à la main fonctionnent le mieux comme tables de faits et ont publié la mémoire associative que nous avons reconstruite, et de Mehta, Singh et leurs collègues, à Microsoft Research et dans des universités partenaires, dont nous avons suivi la boucle écrire, vérifier, réviser. Les deux sont dans les sources.
Sources
- Ok and Lee (POSTECH), Weight-Space Programming Doesn’t Need Transformers (2026)
- Ok and Lee, code and released models (MIT licence)
- Mehta, Singh, Xu, Antonello, Flinker, Mesgarani, Bonner, Jojic and Gao (Microsoft Research, Johns Hopkins, Columbia, NYU), Interpretable weight-space programming builds transparent transformers and brain encoding models (2026)
- Takehi, Teoh, Zhang and Khattab, Sparks of Weight-Space Programming (2026)
- Clark et al., ARC: Think you have Solved Question Answering? (2018)
- Our code and results for this article