Un seul modèle d’IA qui cherche et qui répond : sans moteur de recherche à part
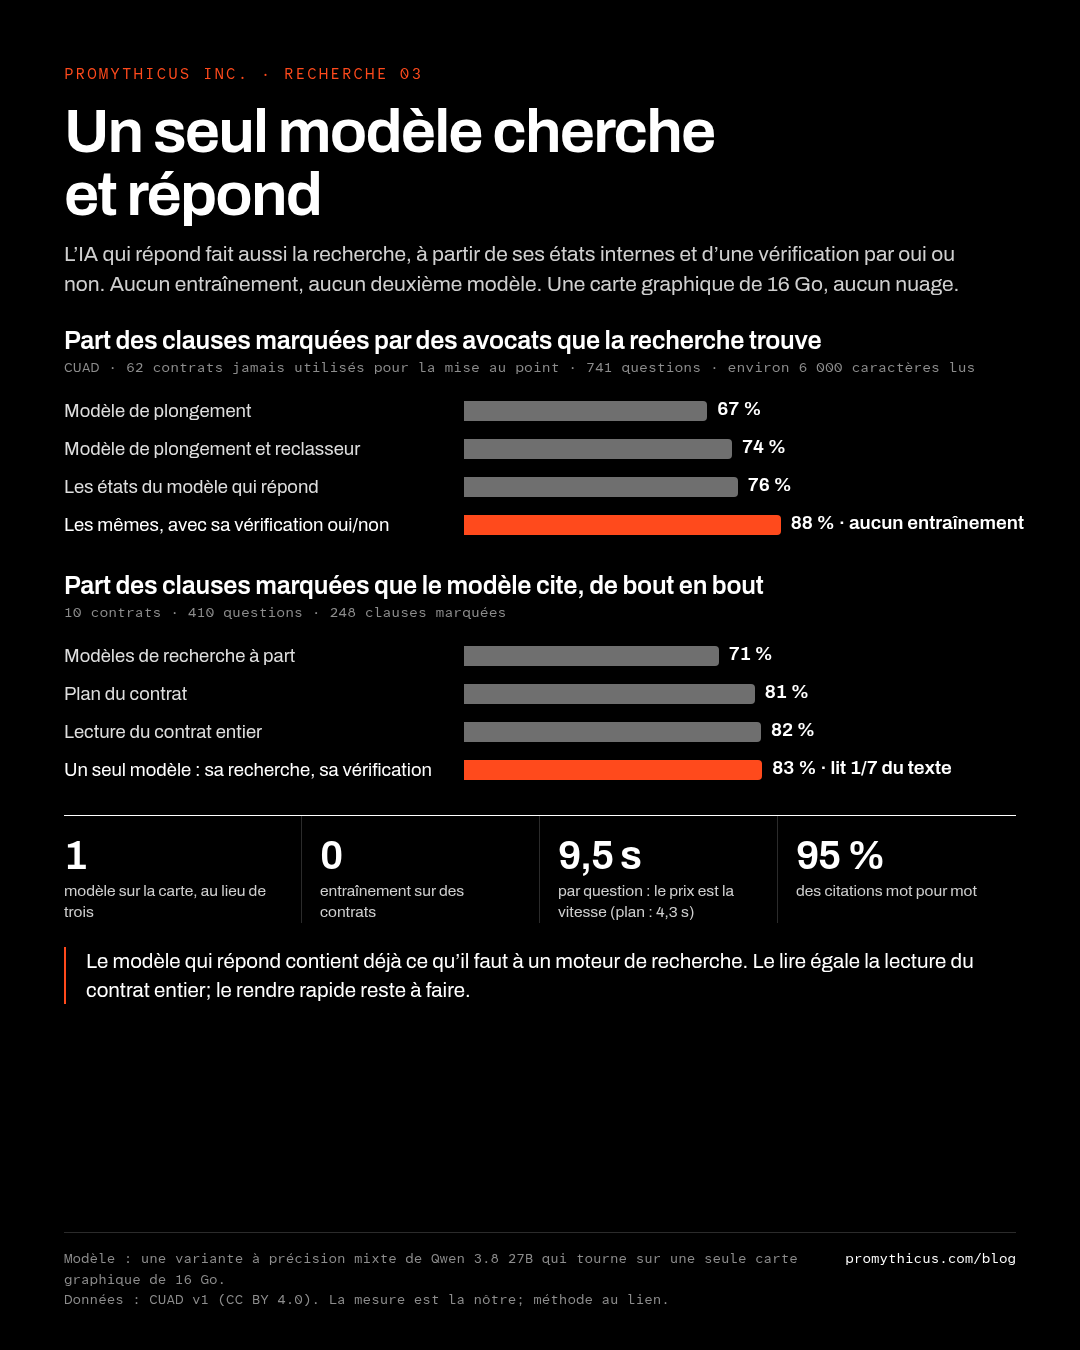
Au test CUAD de révision de contrats, nous avons laissé le modèle qui répond faire sa propre recherche. Ses états internes, lus tels quels, ont trouvé 76 % des clauses marquées; sa propre vérification par oui ou non sur les 30 meilleurs passages a porté ce chiffre à 88 %. De bout en bout, il a cité 83 % des clauses, à égalité avec la lecture du contrat entier (82 %) et avec notre méthode du plan (81 %), en lisant un septième du texte. Rien n’a été entraîné et aucun deuxième modèle n’a été chargé. C’est plus lent : environ 9,5 secondes par question contre 4,3 pour le plan.
La question
Un serveur d’IA privé fait habituellement tourner deux ou trois modèles : celui qui répond, et un ou deux petits qui cherchent (un modèle de plongement et un reclasseur). Sur une seule carte graphique, ils se disputent la mémoire, et il faut en charger et en décharger. Le modèle qui répond peut-il aussi faire la recherche?
L’essai
- Données : CUAD, un ensemble public de contrats commerciaux où des avocats ont marqué les clauses qui répondent à 41 questions types de révision. Les 102 contrats d’essai ont été séparés une fois : 40 pour mettre au point, 62 jamais regardés avant qu’une méthode soit arrêtée.
- Machine : un poste de travail, une carte graphique de 16 Go, aucun nuage.
- Modèle : une variante à précision mixte de Qwen 3.8 27B qui tourne sur une seule carte graphique de 16 Go.
- Mesure : la part des clauses marquées qui se trouvent dans les 12 passages lus (environ 6 000 caractères).
Première étape : les états du modèle comme index de recherche
Quand un modèle de langage lit un passage, chacune de ses couches contient une liste de nombres qui décrit ce qu’il a lu. Nous avons pris ces nombres à une couche du milieu, en moyenne sur le passage, et nous les avons comparés aux mêmes nombres pour la question. Les passages les plus proches sont lus. Aucun entraînement, aucun modèle de plus.
La couche a été choisie sur les 40 contrats de mise au point (la couche 36 sur 64), puis utilisée une seule fois sur les 62 autres.
| Recherche, sans entraînement sur des contrats | Clauses marquées trouvées |
|---|---|
| Un module général publié pour un modèle de 8 milliards de paramètres (CLM) | 29 % |
| Modèle de plongement (Qwen3-Embedding-0.6B) | 67 % |
| Le même avec son reclasseur | 74 % |
| Les états du modèle qui répond | 76 % |
| Les mêmes, puis sa propre vérification par oui ou non sur les 30 meilleurs passages | 88 % |
Les couches 36 à 40 et la couche 52 ont donné presque le même résultat. La dernière couche était mauvaise (24 %) : à ce stade, le modèle pense à son prochain mot, plus à ce que dit le passage.
Deuxième étape : le modèle vérifie sa propre liste
Les 30 meilleurs passages sont soumis au même modèle, un à la fois : « Ce passage contient-il une clause de ce genre? » Nous ne lisons pas sa réponse comme du texte. Nous lisons à quel point il penche vers « oui » plutôt que « non », et nous classons les passages ainsi.
Ce que nous avons écarté : les modules ajustés sur des contrats
Nous avons aussi ajusté un petit module sur le modèle de plongement, à partir des contrats de mise au point. Il a obtenu 88 %. Mais CUAD pose les mêmes 41 genres de questions à chaque contrat. Nous l’avons donc ajusté sur la moitié des genres et essayé sur l’autre : 90 % sur les genres qu’il avait vus, 74 % sur ceux qu’il n’avait pas vus (71 % sans lui). Il avait appris la liste de questions, pas les contrats. Nous l’avons écarté. Le résultat à un seul modèle ne demande aucun ajustement : il n’a rien à mémoriser.
De bout en bout
Trouver le passage, c’est la moitié du travail. Sur les dix contrats et les 410 questions de nos articles précédents, avec la même consigne et la même mesure :
| Façon de lire | Clauses marquées citées | Secondes par question |
|---|---|---|
| Modèles de recherche à part, 12 passages | 71 % | 3,1 |
| Les états du modèle, 12 passages | 73 % | 3,0 |
| Plan, 4 parties | 81 % | 4,3 |
| Contrat entier | 82 % | 3,3 (8,3 pour la première question) |
| Les états du modèle et sa vérification par oui ou non, 12 passages | 83 % | 9,5 |
Avec 248 clauses marquées, les trois dernières lignes sont à égalité : un point ou deux d’écart, c’est du bruit. Les citations étaient mot pour mot 95 % du temps.
Le prix : la vitesse
La vérification par oui ou non lit 30 passages pour chaque question, soit environ 6 secondes. Nous avons essayé de les envoyer tous ensemble et d’en traiter plusieurs à la fois; cela n’a presque rien changé, parce que la carte est déjà occupée à lire. Vérifier 20 passages au lieu de 30 fait gagner un tiers du temps et perdre trois points. Conserver la lecture de chaque passage faite à l’arrivée du contrat, pour que seule la question soit du travail nouveau, est la prochaine chose à essayer.
Et pour un seul contrat qui tient dans la mémoire du modèle, le lire en entier reste le plus simple : il est lu une fois, puis chaque question prend environ 3 secondes. La recherche compte quand le document est trop long, ou quand la question porte sur plusieurs documents.
Limites
- Un seul ensemble de données, des contrats commerciaux américains en anglais, assez courts pour tenir en mémoire. Nous n’avons pas encore essayé une collection de centaines de dossiers.
- La mesure est la nôtre et ne se compare pas aux chiffres publiés sur CUAD.
- Le module publié (CLM) a tourné en précision réduite et nous n’avons pas pu confirmer le format de consigne prévu : ses 29 % le sous-estiment peut-être.
- Un seul passage de chaque méthode.
Questions et réponses
- Un seul modèle d’IA peut-il faire la recherche et la réponse?
- Dans notre essai, oui. Les états internes du modèle qui répond ont trouvé 76 % des clauses marquées, et 88 % avec sa propre vérification par oui ou non, plus qu’un modèle de plongement et un reclasseur à part (74 %). Rien n’a été entraîné.
- Pourquoi est-ce important sur un serveur privé?
- Une carte graphique a une mémoire limitée. Si un seul modèle fait tout, il n’y a rien à charger et décharger, et un seul modèle à installer, à vérifier et à tenir à jour.
- Quel est l’inconvénient?
- La vitesse. La vérification par oui ou non sur 30 passages prend environ 6 secondes par question sur une carte de 16 Go. Pour un seul contrat qui tient en mémoire, le lire en entier est plus rapide.
- Pourquoi ne pas entraîner un petit module sur des contrats?
- Nous avons essayé. Il réussissait sur les genres de questions vus à l’ajustement (90 %) et aidait à peine sur les autres (74 % contre 71 %). Il ne suivrait pas les questions propres à un cabinet.
Sources
- The Atticus Project, CUAD: Contract Understanding Atticus Dataset
- Hendrycks et al., CUAD: An Expert-Annotated NLP Dataset for Legal Contract Review (2021)
- Zhang et al., Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models (2025)
- Contrastive-LM, CLM: Contrastive Language Models (code and released head)