Chercher d’abord ou lire tout le contrat? Une IA locale mise à l’essai sur 102 contrats
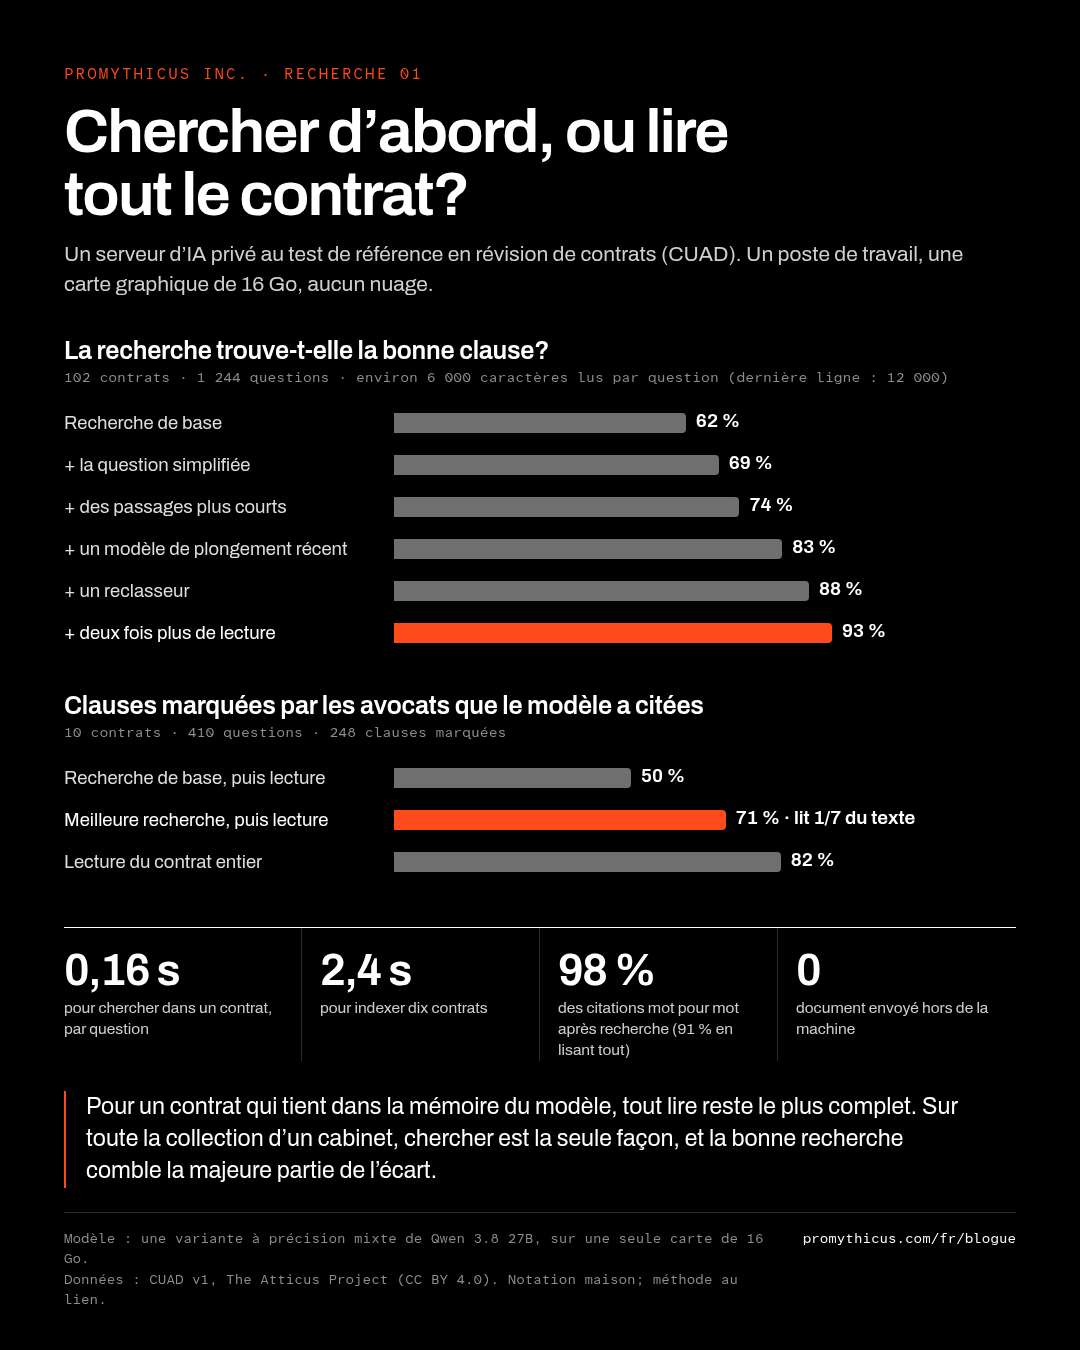
Au test de référence en révision de contrats (CUAD), un modèle local qui lit tout le contrat a cité 82 % des clauses que des avocats avaient marquées. En cherchant d’abord et en ne lisant que les meilleurs passages, il en a cité 50 % avec une recherche de base et 71 % avec la meilleure recherche que nous ayons trouvée, en lisant environ le septième du texte. La recherche elle-même est passée de 62 % à 88 % de clauses trouvées grâce à trois changements : des passages plus courts, un modèle de plongement plus récent et un reclasseur. Tout a tourné sur un seul poste de travail, avec une carte graphique de 16 Go, sans nuage.
La question
Un assistant documentaire privé peut répondre à une question sur un contrat de deux façons. Il peut lire tout le contrat à chaque fois. Ou il peut d’abord y faire une recherche et ne lire que les quelques passages qui semblent pertinents. Seule la seconde façon fonctionne sur toute une collection, car aucun modèle ne peut lire cinq cents contrats pour une seule question. Nous voulions savoir ce que la recherche coûte en exactitude, et jusqu’où on peut l’améliorer.
Le test
- Données : CUAD, un ensemble public de contrats commerciaux dans lesquels des avocats ont marqué les clauses qui répondent à 41 questions types de révision (y a-t-il une clause de non-concurrence, un plafond de responsabilité, un renouvellement, etc.). Nous avons pris la partie d’essai officielle : 102 contrats et 4 182 questions. Les contrats sont en anglais.
- Machine : un poste de travail avec une carte graphique de 16 Go. Rien n’a été envoyé dans le nuage.
- Modèle : une variante à précision mixte de Qwen 3.8 27B qui tourne sur une seule carte graphique de 16 Go.
- Tâche : pour chaque question, dire si le contrat contient un texte sur ce point et le citer mot pour mot.
Quelle recherche trouve la bonne clause
Cette partie ne demande aucun modèle de langage. Pour chacune des 1 244 questions qui ont une réponse, dans les 102 contrats, nous avons vérifié si un passage contenant une partie de la réponse figurait parmi ceux que la recherche renvoyait. Chaque recherche pouvait renvoyer environ 6 000 caractères.
| Recherche | Bonne clause trouvée |
|---|---|
| De base : un modèle de plongement et des mots-clés, passages de 1 200 caractères | 62 % |
| La même, la question réduite au nom de la clause et à sa description | 69 % |
| La même, avec des passages de 500 caractères | 74 % |
| Un modèle de plongement plus récent (Qwen3-Embedding-0.6B), passages de 500 caractères | 83 % |
| La même, avec un reclasseur (Qwen3-Reranker-0.6B) qui réordonne les 30 premiers passages | 88 % |
Avec le double de texte, la meilleure recherche trouve la bonne clause 93 % du temps.
Ce qui n’a rien donné : un modèle de plongement sept fois plus gros (la version 4B n’a pas fait mieux que la 0.6B), l’ajout des mots-clés au modèle plus récent, le titre du contrat placé devant chaque passage, et des passages plus longs (à 2 400 caractères, le résultat tombe à 56 %). Que les passages courts comptent le plus rejoint ce qu’ont rapporté les auteurs de LegalBench-RAG. Contrairement à eux, nous avons constaté qu’un reclasseur aide.
Ce que le modèle a ensuite répondu
Nous avons ensuite laissé le modèle répondre, sur dix contrats assez courts pour être lus en entier (410 questions, 248 clauses marquées), afin que chaque méthode reçoive exactement les mêmes questions.
| Façon de lire | Clauses marquées citées | Citations mot pour mot | Texte lu par question |
|---|---|---|---|
| Recherche de base, puis lecture | 50 % | 99 % | environ 1 300 jetons |
| Meilleure recherche, puis lecture | 71 % | 98 % | environ 1 200 jetons |
| Meilleure recherche, deux fois plus de passages | 73 % | 95 % | environ 2 300 jetons |
| Lecture du contrat entier | 82 % | 91 % | environ 8 400 jetons |
Sur la question plus simple, « ce contrat contient-il une telle clause », les méthodes se valent : la meilleure recherche a dit oui pour 93 % des questions qui avaient une réponse, la lecture complète pour 89 %. La lecture complète a donné un peu moins de fausses alertes (environ le tiers de ses oui ne correspondaient à aucune clause marquée, contre environ quatre sur dix après une recherche).
Ce que nous en retenons
- Si un contrat tient dans la mémoire du modèle, le lire en entier reste le plus complet. Il a cité 82 % des clauses marquées, contre 71 % pour la meilleure recherche.
- C’est dans la recherche que l’exactitude se gagne ou se perd. Le modèle a cité presque toutes les clauses marquées que la recherche lui a mises sous les yeux. Passer de la recherche de base à la meilleure a fait monter le résultat de 50 % à 71 %, avec le même modèle et la même quantité de lecture.
- Une lecture plus courte donne des citations plus fidèles. Après une recherche, 98 % des citations correspondaient au contrat mot pour mot. En lisant tout le contrat, 91 %.
- La recherche est rapide. Indexer les dix contrats a pris 2,4 secondes, et chercher dans un contrat, 0,16 seconde par question. La première question sur un contrat entier a pris 8 secondes en moyenne et 16 pour le plus long; après une recherche, 2,5.
Un assistant sensé fait donc les deux : il cherche quand la question porte sur plusieurs documents, et lit le document en entier quand elle porte sur un seul qui tient en mémoire.
Limites
- Le test de réponse porte sur dix contrats d’au plus 120 000 caractères. Dix des 102 contrats sont plus longs et n’en font pas partie. Le test de recherche porte sur les 102.
- La notation est la nôtre : une citation compte si elle recoupe une clause marquée par les avocats. Ce n’est pas la mesure de l’article sur CUAD; ces chiffres ne se comparent donc pas aux chiffres publiés.
- Un seul modèle, un seul passage. Nous n’avons pas essayé deux méthodes plus récentes, la recherche contextuelle et le découpage tardif.
- Ce sont des contrats commerciaux américains, en anglais. Les documents d’un cabinet se comporteront autrement; c’est pourquoi nous faisons la démo sur les dossiers mêmes du cabinet.
Questions et réponses
- Vaut-il mieux qu’une IA lise tout le contrat ou qu’elle y cherche d’abord?
- Dans notre test, la lecture complète a trouvé davantage : 82 % des clauses marquées par des avocats, contre 71 % pour la meilleure recherche. Mais tout lire ne fonctionne que pour un document qui tient dans la mémoire du modèle. Sur une collection de documents, chercher d’abord est la seule façon.
- Qu’est-ce qui a rendu la recherche plus exacte?
- Trois choses, dans cet ordre : découper les contrats en passages plus courts (500 caractères au lieu de 1 200), prendre un modèle de plongement plus récent (Qwen3-Embedding-0.6B) et ajouter un reclasseur qui réordonne les 30 premiers passages. Ensemble, elles ont fait passer la recherche de 62 % à 88 % de clauses trouvées.
- Un plus gros modèle de plongement cherche-t-il mieux?
- Pas dans ce test. La version à 4 milliards de paramètres du même modèle n’a pas fait mieux que celle à 0,6 milliard.
- Un service infonuagique a-t-il servi à quoi que ce soit?
- Non. Le modèle, la recherche et les contrats étaient tous sur un seul poste de travail, avec une carte graphique de 16 Go.
- Peut-on comparer ces chiffres aux résultats publiés sur CUAD?
- Non. Nous avons noté selon le recoupement entre les citations du modèle et les clauses marquées par les avocats, ce qui n’est pas la mesure de l’article sur CUAD.
Sources
- The Atticus Project, CUAD: Contract Understanding Atticus Dataset
- Hendrycks et al., CUAD: An Expert-Annotated NLP Dataset for Legal Contract Review (2021)
- Pipitone and Alami, LegalBench-RAG: A Benchmark for Retrieval-Augmented Generation in the Legal Domain (2024)
- Zhang et al., Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models (2025)
- Chen et al., M3-Embedding (BGE-M3) (2024)