Nous avons réparé un modèle d’IA en modifiant ses nombres directement. Les idées plus fines ont échoué.
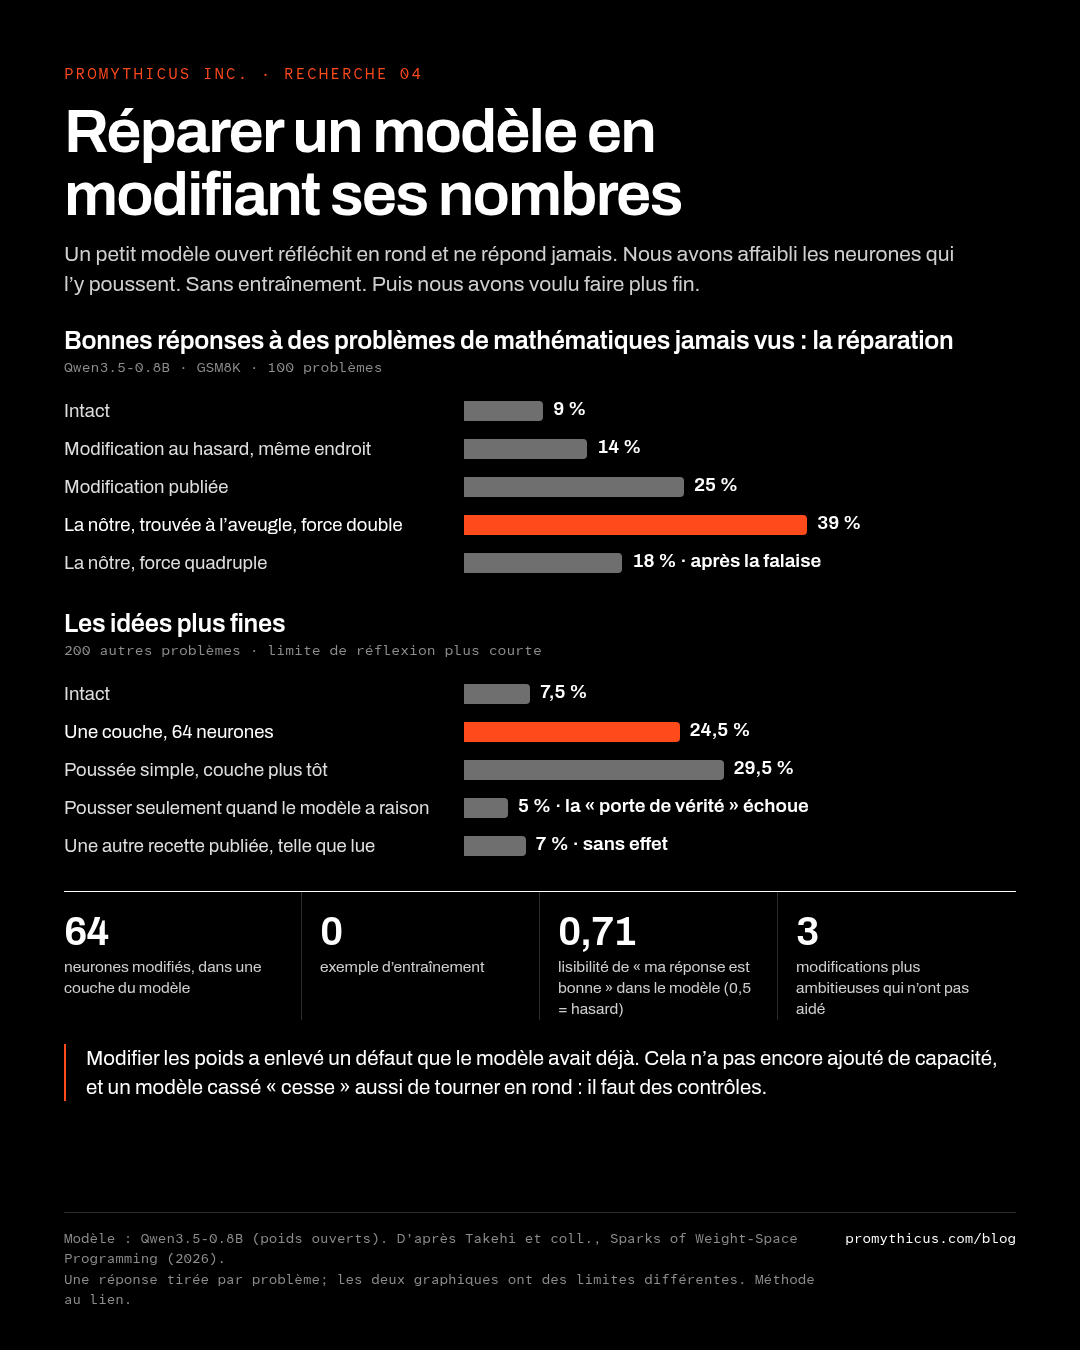
Un petit modèle de langage ouvert (Qwen3.5-0.8B) réfléchit souvent en rond et ne répond jamais. Nous avons trouvé, à partir de son propre comportement, la direction interne qui accompagne ce blocage, et nous avons affaibli les 64 neurones qui poussent le plus dans ce sens. Sans entraînement. Sur des problèmes de mathématiques qu’il n’avait jamais vus, les bonnes réponses sont passées de 7,5 % à 24,5 %. Trois idées plus fines bâties là-dessus (plus de couches, une porte qui n’agit que lorsque le modèle a raison, et une autre recette publiée) n’ont pas aidé. Jusqu’ici, modifier les poids enlève un défaut; cela n’a pas ajouté de capacité.
La question
La façon habituelle d’améliorer un modèle est le réglage fin : un entraînement de plus sur de nouveaux exemples. Il faut des données, des heures de calcul, et l’on risque d’abîmer ce que le modèle faisait bien. Des chercheurs ont montré en novembre 2026 qu’on peut parfois améliorer un modèle en changeant à la main quelques-uns de ses nombres, après avoir observé son comportement. Nous voulions savoir jusqu’où cela va, parce que le serveur d’un cabinet devrait pouvoir s’améliorer sans rien réentraîner.
L’essai
- Modèle : Qwen3.5-0.8B, un petit modèle ouvert au défaut connu : devant un problème de mathématiques, il continue de « réfléchir » et, souvent, ne donne jamais de réponse.
- Problèmes : GSM8K, des problèmes écrits de niveau scolaire. Des problèmes de mise au point pour travailler; d’autres, jamais regardés, pour mesurer.
- Règles : chaque modification est comparée au modèle intact et à une modification au hasard de même taille au même endroit.
Refaire la réparation publiée, à l’aveugle
La réparation publiée change deux des 488 tableaux de nombres du modèle : 64 neurones dans chacune de deux couches. Nous ne l’avons pas copiée. Nous avons fait tourner le modèle intact, séparé les réponses où il se bloquait de celles où il terminait, et cherché les couches qui poussent le plus vers le blocage. Nous sommes arrivés aux deux mêmes couches et à presque la même direction.
| Modèle (100 problèmes jamais vus) | Bonnes réponses |
|---|---|
| Intact | 9 % |
| Modification au hasard, mêmes neurones, même force | 14 % |
| Modification publiée | 25 % |
| La nôtre, même force | 26 % |
| La nôtre, deux fois plus forte | 39 % |
| La nôtre, quatre fois plus forte | 18 % |
Le double de la force publiée était le meilleur réglage. À quatre fois, le modèle cesse de tourner en rond mais répond faux : il y a une falaise, et un petit jeu de mise au point la cache.
Trois idées plus fines
Elles ont été mesurées sur 200 autres problèmes jamais vus, avec une limite de réflexion plus courte; les chiffres sont donc plus bas partout. Le modèle intact obtient ici 7,5 %.
| Modification | Bonnes réponses |
|---|---|
| Aucune | 7,5 % |
| Deux couches | 19,0 % |
| Une couche, plus fort (le choix d’une recherche parmi les couches) | 24,5 % |
| Poussée simple à une couche plus tôt | 29,5 % |
| La même poussée, commandée par un signal au hasard | 21,0 % |
| La même poussée, seulement quand la réponse du modèle est bonne (la « porte de vérité ») | 5,0 % |
| L’image inverse : pousser seulement quand elle est fausse | 9,5 % |
| Une autre recette publiée (AHA), telle que nous l’avons comprise | 7,0 % |
- Plus de couches n’a pas aidé. Un seul groupe de neurones à la bonne force a battu toutes les combinaisons.
- La porte de vérité a échoué. On peut lire, dans le modèle, un faible signe que la réponse qu’il a en tête est bonne (0,71, où 0,5 vaut le hasard). Nous avons écrit à la main deux neurones qui poussent le modèle à conclure seulement quand ce signe est présent. Le résultat est pire qu’avec une porte qui ne lit rien. L’image inverse n’a été écrite que comme contrôle et n’est jamais appliquée à un modèle que nous livrons.
- Nous n’avons pas pu refaire la deuxième recette. Ses auteurs rapportent un gain important; notre version, bâtie d’après leur description, n’a rien changé, à aucune force. Cela dit que notre lecture échoue, pas la leur.
Ce que nous en retenons
La réparation est réelle, importante, et ne demande aucun entraînement. Mais elle enlève un obstacle que le modèle avait déjà; rien ici ne lui a appris quelque chose de nouveau. Et les mesures doivent être prudentes : un modèle simplement cassé « cesse » lui aussi de tourner en rond. Un article récent sur la lecture des poids fait la même remarque, et nous avons adopté ses règles : une modification qui casse le modèle n’est pas un résultat, le bruit se mesure au lieu de se deviner, et chaque série de modifications en contient qui ne devraient rien faire.
Limites
- Un seul petit modèle, avec un seul défaut connu. Le modèle plus grand que nous installons chez nos clients ne tourne pas en rond sur nos tâches; cette réparation n’a donc encore rien à y corriger.
- Une seule réponse tirée par problème. Des écarts de quelques points sont dans le bruit; le saut de 7,5 % à 24,5 % ne l’est pas.
- Les deux tableaux utilisent des limites et des problèmes différents et ne se comparent pas entre eux.
Questions et réponses
- Peut-on améliorer un modèle d’IA sans réglage fin?
- Parfois. Dans notre essai, modifier 64 neurones dans une couche d’un petit modèle, sans entraînement, l’a fait passer de 7,5 % à 24,5 % de bonnes réponses sur des problèmes jamais vus. Cela a fonctionné parce que le modèle avait un défaut précis : il se bloquait dans sa propre réflexion.
- Qu’est-ce qu’une modification des poids?
- Un modèle est un grand ensemble de nombres. Une modification des poids en change quelques-uns, choisis, directement, après avoir observé le comportement du modèle, au lieu de l’entraîner sur de nouveaux exemples.
- Est-ce que cela fonctionne pour tout?
- Non. Dans nos essais, cela a enlevé un défaut. Les modifications plus ambitieuses, dont une qui devait faire conclure le modèle seulement quand il a raison, n’ont rien donné ou ont nui.
- Est-ce utilisé sur les serveurs des clients?
- Pas encore. Le modèle que nous installons n’a pas ce défaut. Nous vérifions si la même approche peut corriger ceux qu’il a.
Sources
- Takehi, Teoh, Zhang and Khattab, Sparks of Weight-Space Programming (2026)
- Ahmed, Can an LLM Actually Reason and Program about Neural Network’s Weights? (2026)
- Khamis, Tutunov and Bou Ammar, Who Needs an LLM to Program an LLM? Introducing AHA! (2026)
- Kocabay, Weight-Space Reading (2026)
- Cobbe et al., GSM8K: Training Verifiers to Solve Math Word Problems (2021)